
- При составлении СЯ как правило практикуется 2 подхода:
- сбор как можно более полного семантического ядра;
- парсинг удачных конкурентов.
В первом варианте используются все возможные источники начиная от подсказок Вордстат и заканчивая базами MOAB и Паcтухова. Ядро получается наиболее полным, тематика раскрывается полностью, но надо учитывать, что при таком подходе "выстреливают" (выходят в ТОП) примерно 20% статей.
При втором подходе парсятся только успешные конкуренты, у которых большинство ключей уже в ТОПе. В данной статье рассмотрим именно этот вариант.
Содержание
Что такое семантическое ядро сайта
Семантическое ядро — это поисковые запросы, по которым ваш сайт могут искать пользователи поисковых систем, таких как Яндекс, Google и т.д.
Как правильно составить семантическое ядро
- Вместо долгого и достаточно дорого составления СЯ можно просто "подсмотреть" по каким ключам вышли в ТОП ваши конкуренты:
- подбор ключевых слов;
- бесплатный анализ конкурентов;
- платный анализ конкурентов.
Ручной метод (с использованием Wordstat)
Самый простой и понятный способ сбора ключевых слов — использование официального сервиса от “Яндекса” wordstat.yandex.ru. Он представляет статистику “по каким фразам и что искали пользователи “Яндекс” за последний месяц, год и т.д”.
Вбиваем любую фразу и видим сколько раз ее искали в Яндекс. Естественно в работу пускаются только наиболее частотные запросы.
- данный способ бесплатен;
- но требует больших трудозатрат;
- с его помощью невозможно собрать полное ядро.
Можно "обогревать космос" подбирая ключи с помощью Яндекс Вордстат, и зная что "выстрелят" всего 20% ваших статей. А можно сразу писать статьи под эти 20% ключей, подсмотрев их у конкурентов.
Бесплатный метод (на основе Megaindex)
Шаг 1. Выбираем достойного донора среди конкурентов
Нам нужно отобрать доноров по нашей тематике, которые имеют высокую посещалку естественным путем.
- "Донор" - это лучший из конкурентов, с которого стоит брать пример, на который стоит ориентироваться:
- сайт относительно молод: 6-18 месяцев;
- не очень большое количество статей: 100-200 шт.;
- основной трафик из поисковых систем;
- не продвигался покупными ссылками;
- 20 и более уникальных посетителей на страницу.
- Посещаемость смотрим из открытой статистики LiveInternet (Li), допустим, по сервису Пелевина. Я обычно смотрю в диапазоне 2-8k уников, ниже не интересно, выше - всякий шлак.
- Обратные ссылки смотрим по LinkPad (можно прямо в RDS bar).
- В сервисе SimilarWeb проверяем чтобы трафик шел в основном с поисковых систем.
Не рассматриваем сайты, которые высоко ранжируются в силу:
- большого возраста;
- большого количества статей;
- большого количества ссылок на сайт;
- основной трафик из соц. сетей по непонятным схемам.
Шаг 2. Парсим ключи
Идем в Megaindex / SEO сервисы / Видимость сайта
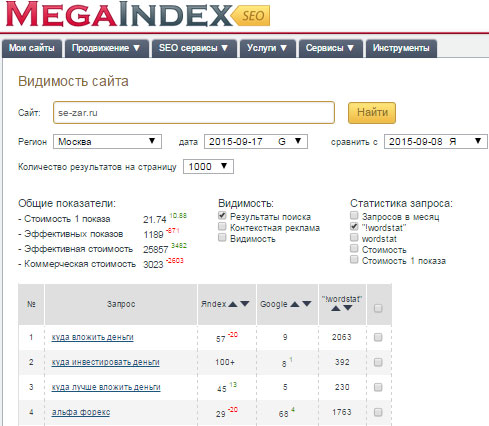
Ни отсортировать, ни изменить здесь мы ничего не можем, поэтому просто экспортируем в CSV.
Для тех, кто сомневается, что Megaindex правильно выделяет ключи, по которым идет трафик:
- посмотрите в LiveInternet, по каким ключам на ваш сайт идут пользователи;
- просканируйте ваш сайт в Мегаиндекс;
- сравните результаты ключей.
Надеюсь, все вопросы отпадут.
- Открываем полученный файл csv в Excel, сортируем и оставляем только ключи:
- частотностью по "!wordstat" более 300;
- позиции в Яндекс и Google 1-20;
- сложность: 2-3 слова.
Почему только 2-3 словные фразы? Однословные ключи являются ВЧ и вышли в ТОП в результате работы более широких ключей.
Шаг 3. Кластеризация семантического ядра
Группируем ключи и создаем структуру сайта. После второго шага мы получили унылую портянку ключей. Многие из них на одну тему и следовательно войдут в одну статью. Теперь их нужно отсортировать по отдельным статьям и далее статьи по разделам (рубрикам). Это можно сделать вручную или с использованием бесплатных сервисов.
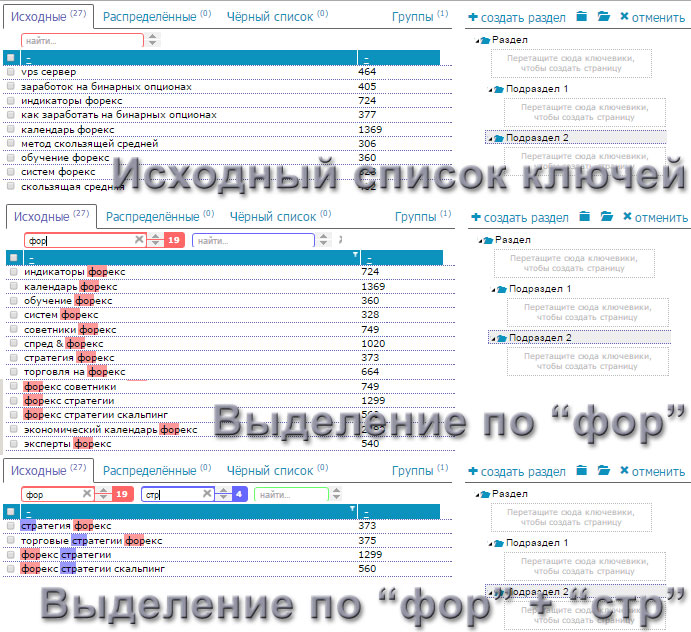
В итоге у нас остались только необходимые ключи, на основе которых мы будем писать статьи. Но предварительно эти запросы необходимо структурировать, создав таким образом будущие разделы (рубрики) нашего сайта. Поможет нам в этом бесплатный сервис KeyAssistant. Создаем папки и подпапки (в дальнейшем это будут разделы и подразделы меню нашего сайта) и переносим в них выбранные ключи. Перед переносом ключи можно группировать по необходимым словам, то есть переносить не по одному ключу, а сразу необходимую группу ключей.
Что понравилось:
- Страница в структуре KeyAssistant автоматически принимает название по ключу с максимальной частотностью "!wordstat", и в ней показывается суммарная частотность всех ключей.
- Если в проект добавить еще csv со спарсенными ключами, то дубли уберутся автоматически. То есть нет необходимости собирать ключи в один файл, можно их добавлять по мере нахождения новых интересных сайтов.

Четыре выделенных ключа поместили в подраздел, и имя страницы автоматически скопировалось с самого "жирного" ключа.
Далее полученную структуру можно экспортировать в csv и по ней выдавать задания копирайтерам на написание статей:

Сколько ключей мы должны получить в итоге (или иными словами - сколько тем для написания статей)?
Лучше иметь 5-10 сайтов разной тематики по 100 статей, чем один сайт на 1000 статей. Этим мы снизим риски пессимизации от ПС.
Платный метод (используя Keys.so)
- Что такое Keys.so?
- keys.so - онлайн-сервис для анализа семантики конкурентов с огромной базой ключевых слов
- Зачем использовать платный способ?
- более широкая база;
- более чистая база;
- автоматический охват всех конкурентов;
- можем узнать все сайты нашего конкурента по коду Adsense, Analytics, Leadia.
Например мы нашли классный сайт, а есть ли у данного вебмастера еще сайты? Код Adsense то он ставит везде одинаковый, вот по нему то мы и вычислим всю сетку сайтов. Аналогично по кодам Leadia и Analytics.
Шаг 1. Найти конкурентов из ТОП
- Берем сайт своего "любимого" конкурента и жмем "Анализировать".
- Открываем всех конкурентов "Конкуренты - Открыть все".
- Ставим тематичность 10, похожесть 4 и жмем "Применить", этим мы уберем крупные порталы типа kakprosto.ru, которые пишут обо всем подряд.
- Выгружаем в Эксель, проверяем вручную, удаляем ненужные сайты:
• которые не совсем по нашей тематике;
• старше 3 лет (исключаем фактор возраста);
• у которых основной трафик не из поиска (исключаем арбитраж);
• которые сильно "пихались" ссылками (исключаем фактор ссылочного);
• с посещалкой меньше 10 на 1 страницу (зачем нам такие неудачники).
Цель первого подхода - найти конкурентов которые вырвались в ТОП и имеют большую посещалку благодаря удачно подобранным ключам, а не в силу своего возраста, покупных ссылок и т.д.
В принципе на этом можно и остановиться и перейти к финальному этапу сбора ключей, но мы нашли еще не всех конкурентов.
Шаг 2. Найти конкурентов конкурентов
- Переходим на вкладку "Групповой отчет" и вводим оставшихся после чистки в первом подходе конкурентов, жмем – "Анализировать".
- Переходим на вкладку "Конкуренты группы" и фильтруем по "Похожесть 30".
- Выгружаем в Эксель, еще раз ручками перебираем конкурентов наших конкурентов и убираем ненужных.
Цель второго подхода - найти конкурентов наших конкурентов.
Надеюсь теперь мы нашли всех наших конкурентов.
Шаг 3. Финальный этап
- Опять заходим в "Групповой отчет" и вводим конкурентов из 1 и 2 подхода.
- Фильтруем по:
• “!wordstat” больше 10;
• конкурентов больше или равно 2; - выгружаем в csv.
В результате получаем большую портянку ключей, по которым наши крутые конкуренты вышли в ТОП. Осталось только разгруппировать.
Аудит семантического ядра сайта
Стоимость качественного семантического ядра с кластеризацией велика. Чтобы не брать "кота в мешке" попросите исполнителя предоставить семантику по одному запросу. Как правило это делается бесплатно. Прогоните полученные ключи через Мутаген и посчитайте число высокочастотных, но низкоконкурентных ключей. Часто встречаются исполнители которые предоставляют большое количество ключей, но рабочих из них крайне мало.
Вот почему я до сих пор предпочитаю собирать семантическое ядро самостоятельно.

Chebor (создатель Keys.so) на одном из форумов так описывает алгоритм работы с программой.
Как пользовать:
1. берем сайт-будущий конкурент, генерим отчет
2. открываем конкурентов
3. выписываем тех, где похожесть и тематичность выше, например, 15% (точное число зависит от тематики и подбирается по принципу "чтоб точно конкуренты и в рамках темы"
4. для этой пачки делаем групповой отчет
5. открываем страницу конкурентов, добиваем в отчет всех, кто по теме и жирный. Например, просто ставим фильтр на количество ключей в топ50 > 5000 и похожесть >= 75%, все это так же пихаем в список доменов для генерации группового отчета. Итак, за 2 минуты мы составили список всех заметных конкурентов в тематике, их у нас получилось около 30.
6. получаем новый групповой отчет и вот перед нами примерно 180к ключей в теме, мы скачиваем CSV и фильтруем примерно так - "только те запросы, где есть два и более конкурента, частотность - от 30" - вы получите 45к отборных ключей в теме, если "где есть три и более конкурента" - 34к ключей, но там уже будет совсем-совсем мало не тематических и случайных запросов.
Вариант если есть раскрученный сайт:
1. Открываем список конкурентов, фильтруем. Фильтр предлагаю следующий: запросов от 5000 (нам не интересны маленькие сайты) + похожесть от 10 (как минимум 10% наших ключей должны быть в списке ключей жертвы) + тематичность от 20 (как минимум 20% ключей жертвы должны быть в списке наших ключей). Хоп - у нас всего пять конкурентов осталось. Готов поспорить, что это наиболее заметные твои конкуренты. Копируем список.
2. Генерируем групповой отчет по этим пяти доменам + твой домен, т.е. итоговый список: dezhur.com,ipinform.ru,ipopen.ru,moyafirma.com,russtartup.ru,znaydelo.ru
3. Ждем пока сгенерится, ставим чайничек.
4. Чайник только начал закипать, а отчет готов. Открываем, видим, что в отчете 237 534 ключа. Это что то много, надо б пофильтровать.
5. Ставим фильтр - конкурентов больше или равно 2, "вордстат" больше или равно 50 - таким образом мы откинем непопулярные ключи и ключи, в которых был только один сайт из группы. Зачем учитывать сайты из группы? Да просто чем больше конкурентов встретилось в топ50 - тем более тематичен запрос. Какой нить ipopen.ru мог случайно занять 38 место по запросу "как подстричь пуделя", но как минимум два сайта из группы в топе - почти однозначный признак тематичности. По хорошему то я больше люблю групповые отчеты по 20-30 доменам, и фильтр уровня "не менее 5 конкурентов". Но мы ж сейчас быстренько только проверяем. В общем - 30 332 запроса. Скачиваем CSV
6. Идем обратно в наш домен, вкладка запросы, ставим фильтр - позиция меньше или равна 20 - 16 790 ключей, скачиваем CSV
7. В любой программке по работе с ключами вычитаем из первого (группового) CSV второй, у нас останется как минимум 13 000 (скорее что нить уровня 18к) ключей по очень-твоей-тематике, где твой сайт не занимает позиций в топ20. Т.е. логично было бы посмотреть на них повнимательнее, наверняка среди них есть темы для новых хороших статей. А если мой сайт и так на 38 позиции? Ну все просто - или материал новый и только начал покорение топа - тогда ждать, или же материал хреново отвечает на запрос и тогда надо переписывать или писать новый материал. Отсюда и фильтр по позиции в шаге номер 6.
Разумеется, поиграв фильтрами на шаге 1 ты можешь расширять тематику будущего списка ключей или дополнительно сужать ее. В пункте 6 ты можешь подкорректировать жадность алгоритма - может для тебя нахождение в топ30 уже достаточная стартовая точка до дожима запроса в топы. В общем вариантов изменения подхода довольно много.
Если на входе не свой сайт, а сайт-видный-конкурент - соответственно пункты 6-7 не нужны.
Пример как собрать семантическое ядро про Рыбалку:
Пример как собрать семантическое ядро про Бани:
Пример как собрать семантическое ядро про Путешествия: